Посмотреть на ограничения
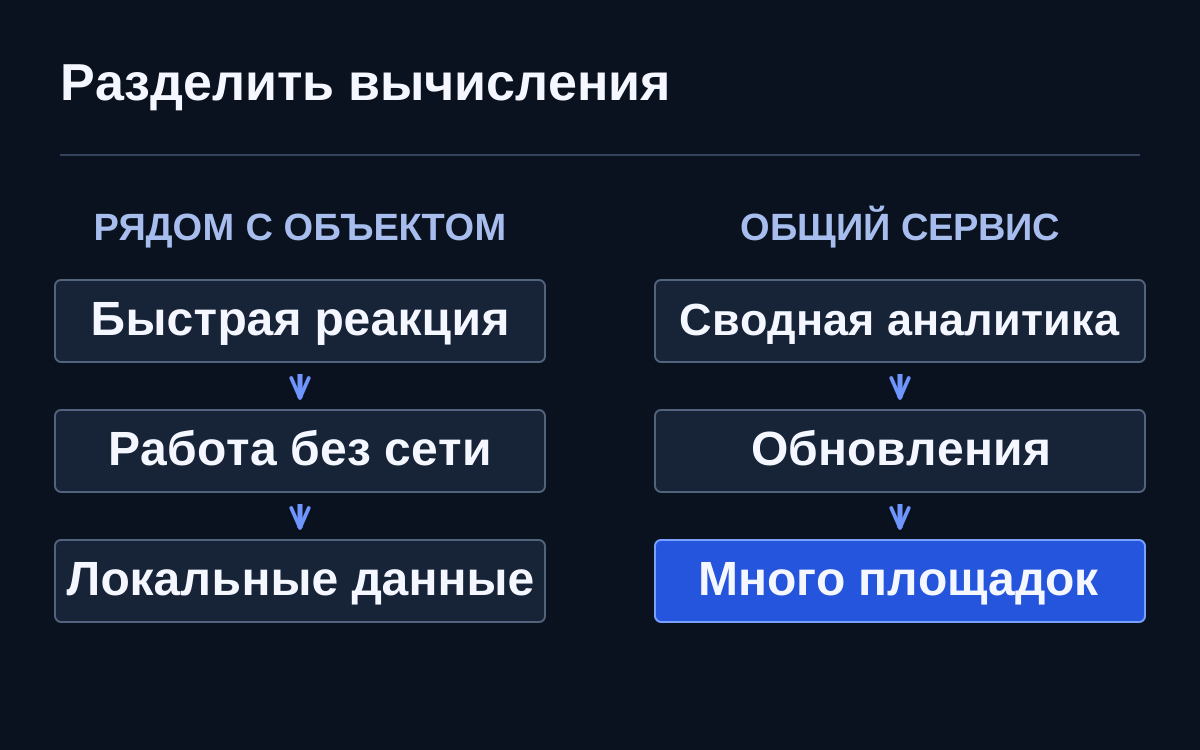
При нестабильной связи и необходимости быстрого ответа часть данных обрабатывают рядом с источником. Для объединения сведений со многих площадок используют централизованный сервис. Выбор зависит от задержки, доступности канала и работы, которую система должна продолжать при его потере.
Один объект, несколько разных задач
Представим условную камеру на производственной линии. Ей нужно быстро обнаружить препятствие, сохранить событие для расследования и передать сводку в аналитику нескольких площадок. Эти задачи имеют разную чувствительность к задержке и потере связи. Поэтому вопрос не обязательно решается выбором одного места для всех вычислений. Срочная локальная реакция, хранение и общая аналитика могут быть разделены по требованиям к результату.
Сначала запишите, что должно происходить без сети. Может ли система продолжать безопасную работу, сколько событий сохранить и какие функции временно отключить? Затем определите, какие сведения нужны центральному сервису: полный поток или уже выделенные события. Передача только необходимого может уменьшить нагрузку на канал, но сокращает возможности повторного анализа. Этот компромисс должен быть осознанным и связанным с конкретной задачей.
Локальное вычисление тоже требует инфраструктуры
Устройство на объекте нужно установить, обновлять, контролировать его состояние и заменять при отказе. У него ограничены питание, охлаждение и вычислительные ресурсы. Если обновление модели меняет поведение, потребуется проверка до массовой установки. Облако убирает часть забот о конкретном оборудовании, но добавляет зависимость от канала, внешнего сервиса и схемы оплаты. Сравнивать только скорость демонстрационного запроса недостаточно.
Для распределённой системы важна совместимость версий. Пока часть устройств уже обновилась, другая может оставаться без связи. Центральная аналитика должна понимать, по каким правилам получены события и можно ли их сравнивать. Это особенно заметно, если новая модель иначе определяет один и тот же объект. Версия обработки и время события становятся частью полезных данных, а не технической подробностью для разработчиков.
Проверка должна включать отказ
Во время пилота смоделируйте потерю канала, перезапуск устройства и заполнение локального хранилища. Посмотрите, что видит оператор, какие события теряются и как система возвращается к нормальной работе. Отдельно проверьте восстановление порядка: событие, доставленное позже, не должно незаметно выглядеть как новое. Такие испытания полезнее сравнения двух идеальных сценариев на стабильном соединении и пустой очереди.