Сбой глазами пользователя
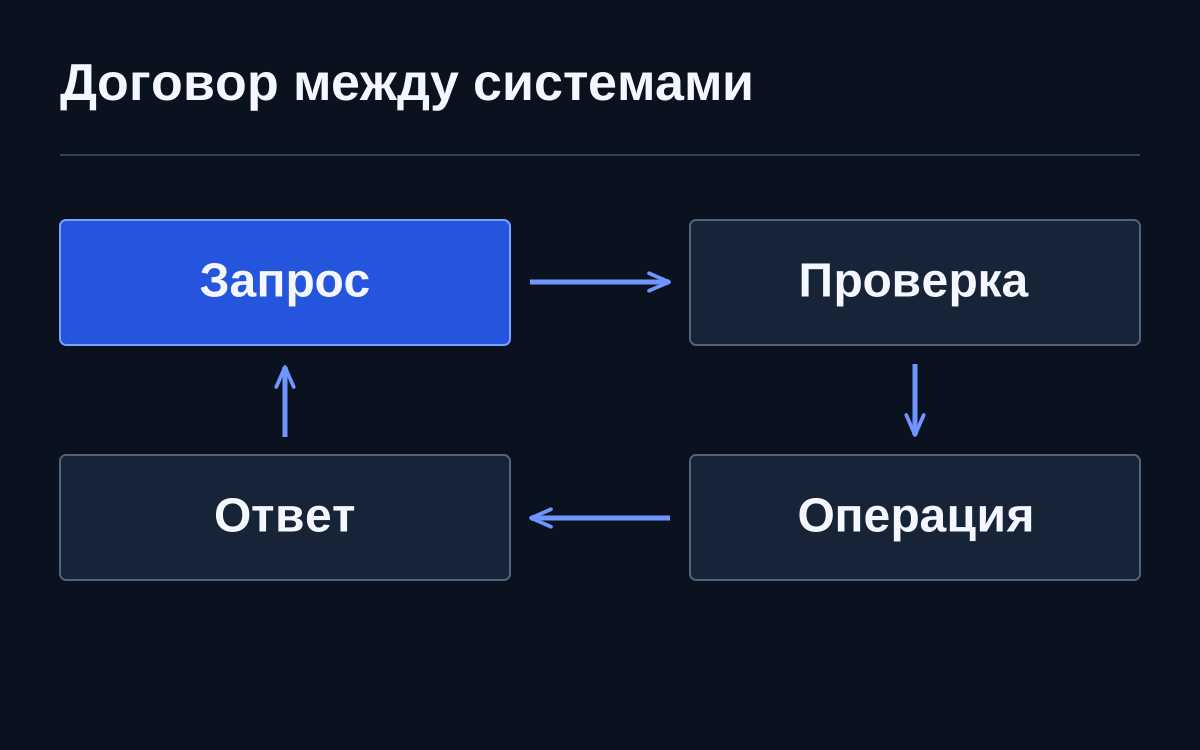
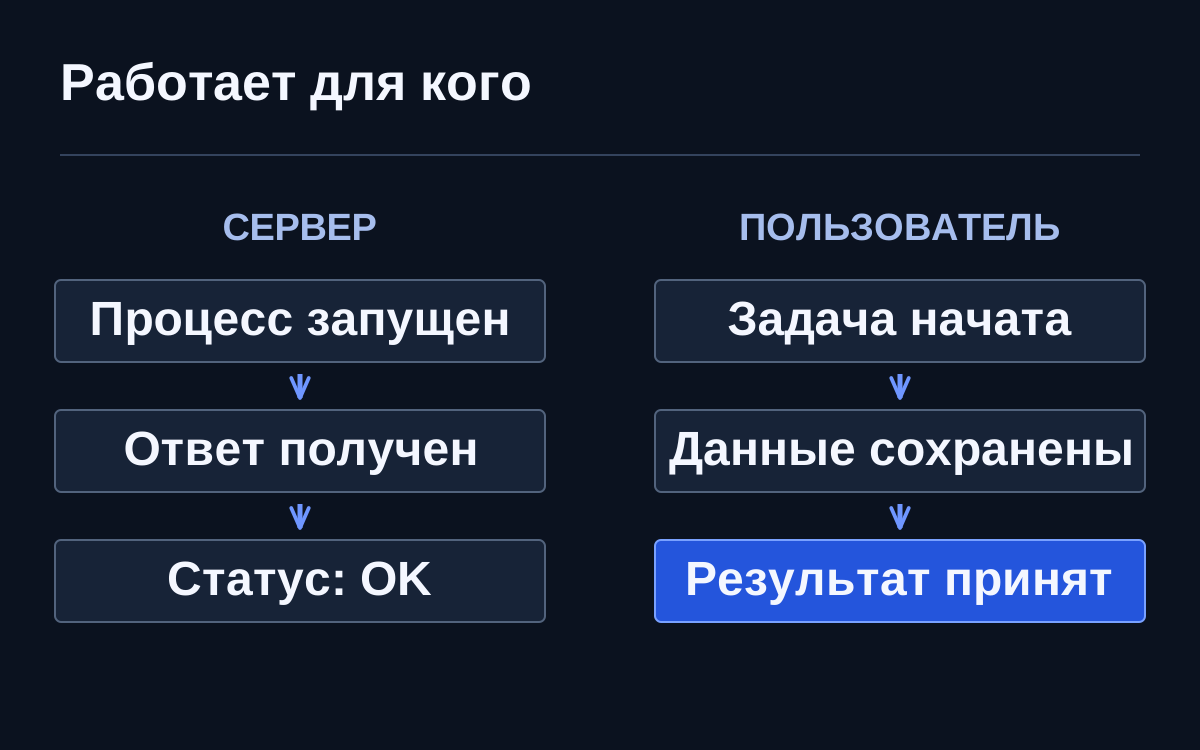
Сервер отвечает, но заявление не сохраняется. Технический мониторинг показывает доступность, а пользователь видит отказ. Надёжность сервиса измеряют через действия, ради которых он существует: поиск записи, оформление заявки, получение документа.
Пример: запись в кружок
Представим вымышленный городской сервис. Страница кружков открывается быстро, но сохранение выбранного места периодически завершается ошибкой. Проверка главной страницы показывает доступность, тогда как родителям приходится начинать запись заново. Разные наблюдатели честно описывают разные участки одного процесса.
Для этого маршрута можно считать долю корректных попыток записи, после которых место действительно закреплено и пользователю показано подтверждение. Нужно заранее определить, как учитывать повторные нажатия и незавершённые действия. Иначе улучшение интерфейса изменит число попыток, а метрика сдвинется без изменения надёжности самой операции.
Процент требует знаменателя
У показателя должны быть период наблюдения, состав операций и критерий успеха. Ошибка ввода пользователя и отказ системы — разные события, однако спорные случаи нельзя исключать задним числом ради хорошего результата. Правила учёта записывают до обсуждения итогового числа и пересматривают явно.
В условном примере десять неуспешных попыток из тысячи составляют один процент. При этом десять разных людей и десять повторов одного человека создают разный пользовательский опыт. При необходимости рядом с долей операций показывают число затронутых пользователей.
Время и правильность дополняют доступность
Операция может завершаться успешно, но настолько медленно, что человек её бросает. Поэтому определение успеха иногда включает приемлемое время ожидания. Среднее значение способно скрывать редкие долгие задержки; полезно смотреть распределение и отдельно разбирать медленные случаи. Выбранный способ должен соответствовать назначению сервиса.
Есть и смысловая правильность: запись сохранена, но на другую дату. Технический ответ об успехе такой проблемы не обнаружит. Проверки контрольного маршрута и обращения пользователей помогают дополнить инфраструктурные наблюдения. Как подчёркивает Google SRE, измерение только на серверной стороне может пропускать проблемы, видимые у клиента.
Цель должна менять решения команды
Если SLO регулярно нарушается, нужна заранее согласованная реакция: разобраться в причинах, уменьшить риск ближайшего изменения или выделить время на устранение повторяющегося сбоя. Без связи с работой цель остаётся декоративным числом. Ответственный должен понимать, какие действия запускает ухудшение и кто принимает решение.
Не стоит назначать одинаковую цель каждой функции по привычке. Просмотр справочной страницы и отправка важной заявки отличаются последствиями отказа. Более жёсткие ожидания требуют ресурсов на разработку, проверку и сопровождение. Обсуждать их полезнее через пользовательский ущерб и стоимость восстановления, чем через престиж большого процента.
Начать с одной прозрачной метрики
Выберите критичный маршрут, запишите определение успеха и проверьте, откуда берётся числитель и знаменатель. Затем сравните наблюдения с несколькими известными сбоями: отразились ли они на показателе? Если пользователи не могли работать, а число осталось идеальным, измерение нуждается в уточнении.